Threads digest · @edutrend_
에이전트·협업AI는 어떻게 경험을 물려받을까
2,500만 번의 게임과 네 번의 연습 라운드. 이 차이를 이해하는 열쇠는 AI의 사전지식과, 다음 세대에 물려주는 마크다운 공략집에 있습니다.
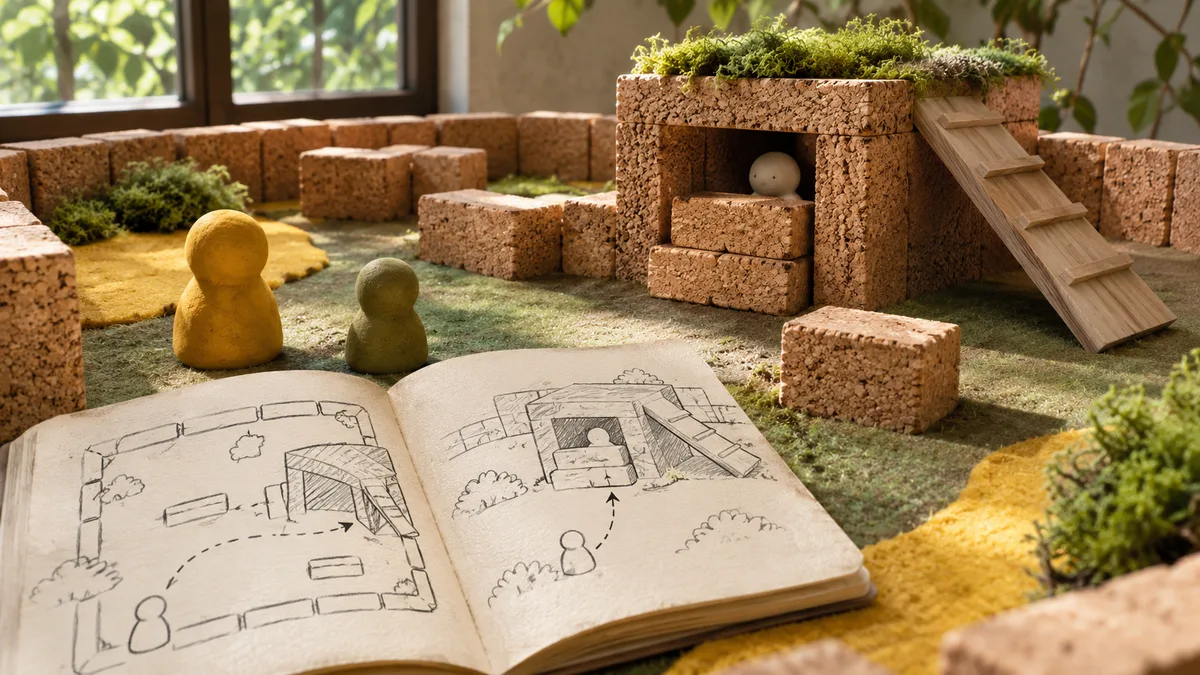
2,500만 번과 네 번, 무엇이 달라졌을까
AI에게 숨바꼭질을 시켰습니다. 네 번째 연습 라운드에서 AI가 은신처를 만들기 시작했습니다.
2019년 실험에서는 AI가 이 행동을 터득하기까지 약 2,500만 번의 게임이 필요했습니다. 그런데 어떻게 단 네 라운드 만에 가능했을까요?
여기서 한 라운드는 다섯 판으로 이루어진 연습 묶음입니다. AI가 ‘경험을 물려받으며 진화하는 방식’을 정리해 드립니다.
백지에서 시작한 AI, 이미 알고 있는 AI
2019년 숨바꼭질 AI는 아무런 상식 없이 태어난 ‘백지’ 상태였습니다. 벽이 뭔지, 숨는 게 뭔지도 몰라 수천만 번 무작위로 몸을 부딪치며 우연한 성공을 기다려야 했죠.
하지만 지금의 AI는 이미 방대한 언어와 세상을 학습해 ‘벽으로 틈을 막으면 숨을 수 있다’는 개념을 머릿속에 알고 있습니다.
치트키 없이, 눈앞의 화면만 보고 움직이기
그렇다면 실제로 움직이는 건 어떻게 배웠을까요?
AgentGarten 연구진은 AI에게 좌표나 숨겨진 맵 데이터 같은 ‘치트키’를 주지 않았습니다. 사람처럼 오직 눈앞에 보이는 1인칭 화면만 보고 직접 코드로 몸을 조작하게 했습니다.
연습이 끝나면, 마크다운 반성문을 남긴다
진짜 핵심은 한 라운드가 끝난 뒤에 일어납니다. 게임을 마친 AI는 반성문을 씁니다.
‘시야만 가려선 안 되고 입구 자체를 틀어막아야 함’ 같은 실전 팁을 담은 공략집, 즉 플레이북을 마크다운(.md) 문서로 남기는 것이죠.
다음 AI는 빈 도화지에서 시작하지 않는다
다음 라운드에 들어온 새로운 AI는 빈 도화지에서 시작하지 않습니다. 이전 세대 AI가 남겨둔 공략집들을 정독한 뒤 다음 전략을 펼칩니다.
그 결과, 네 번째 라운드에는 차폐벽으로 은신처를 구축했습니다. 열 번째 라운드에는 술래가 경사로를 가져와 벽을 타고 침투했습니다.
행동하고, 기록하고, 경험을 물려주기
AI의 학습 패러다임이 완전히 바뀌고 있습니다.
수억 번 넘어지며 몸으로 체득하는 방식에서, ‘행동하고 → 글로 실패를 정리하고 → 다음 세대에 경험을 물려주는’ 인간 고유의 문화적 축적 방식으로 진화하고 있습니다.
여러분은 이 ‘오답 노트 물려주기’ 방식에 대해 어떻게 생각하시나요?
이 글에서 소개한 원문
AgentGarten: Code Worlds for Evolving Agents
Jiawei Chi, Shangchen Miao, Zhiyuan Shi, Kailu Wu, Hanyang Wang, Weiliang Chen, Qiyu Dai, Jinshan Ren, Jun Gao, Mingsheng Long, Yueqi Duan, Jiangran Lyu, Jialong Wu, Fangfu Liu (2026)
프리프린트 · arXiv v1 · arXiv:2610.12374v1
연구 원문 보기 ↗