Threads digest · @edutrend_
에이전트·협업AI는 실험에 성공하고도 왜 성공을 선언하지 않았을까요?
오전 11시 48분에 켜진 실험실 조명이 성공처럼 보이던 결과를 다시 보게 했습니다. 75개 제안의 기각부터 대조군 검사와 재실험까지, 서로를 비판하고 멈춰 세울 수 있는 AI 연구팀의 과정을 따라갑니다.
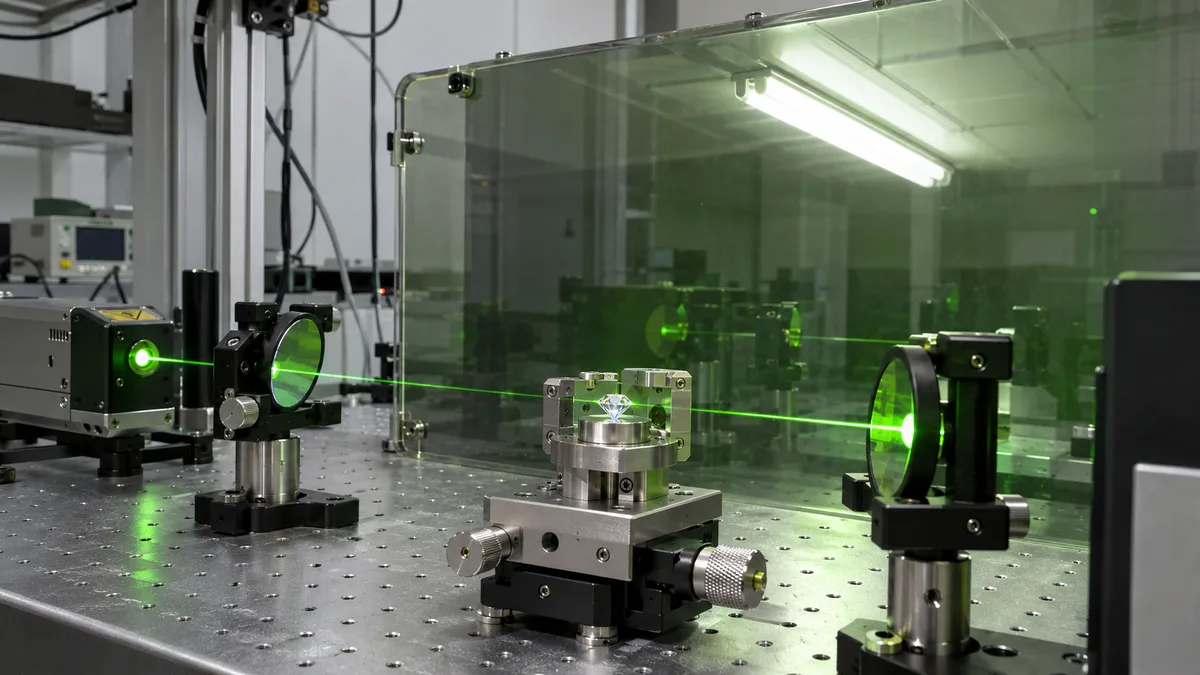
실험실 불 하나에 멈춰 선 AI 연구팀
오전 11시 48분, 누군가 실험실 형광등을 켰습니다. 그 무렵 측정 신호가 갑자기 달라졌고, AI 연구팀은 좋아 보이던 실험 결과를 그대로 성공으로 인정하지 않았습니다.
도쿄과학대 연구진은 서로의 제안과 결과에 딴지를 걸고, 기준에 못 미치면 진행을 멈출 수 있는 AI 연구팀을 실제 다이아몬드 양자 실험실에 투입했습니다. 이름은 Auctopus입니다. 그럴듯한 답을 만들어내는 능력만큼, 자기 결과를 기각할 수 있는 구조에 주목한 연구입니다.
혼자 다 하지 않고 여섯 역할로 나눴습니다
아이디어 제안, 연구책임, 수치 검증, 실험 수행, 관리, 심사라는 여섯 주요 역할을 나눴습니다. 제안팀의 GPT-5.6이 연구 질문을 내놓으면, 연구책임자 역할의 GPT-6 Pro가 제안을 심사하고 수학적 근거를 따졌습니다.
GPT-6 Astra는 계산으로 결과를 검증하고, Claude Fable 5는 실험실 장비를 제어했습니다. Claude Opus 5 등을 활용한 관리·심사 역할은 중복 아이디어를 걸러내고 연구의 흐름과 최종 결과를 검토했습니다.
약 30시간 동안 75번의 퇴짜
가장 눈에 띄는 장면은 연구책임자 AI의 기각이었습니다. 제안팀이 가져온 75개 아이디어를 약 30시간에 걸쳐 연속으로 탈락시켰습니다. 이미 알려진 내용이거나, 논리가 빈약하거나, 실제 실험으로 확인하기 어렵다는 이유였습니다.
비슷한 제안이 계속되자 관리 담당 AI가 거절된 방향을 금지 목록으로 정리했습니다. 무엇을 하지 말아야 하는지 공유한 뒤에야 제안이 새로운 방향으로 움직이기 시작했습니다.
91개라는 제안에서 10개의 보정 설정으로
선택된 질문은 다이아몬드 속 양자 스핀의 반응을 예측하려면 사전 보정 측정이 최소 얼마나 필요한가였습니다. 제안팀은 펄스 세 개를 쓰는 경우 최대 91개 설정을 제시했습니다.
연구책임자 AI는 직접 수학적 관계를 도출해, 논문이 다루는 조건에서는 독립적인 보정 설정이 L²+1개면 충분하고 그보다 적게는 안 된다는 법칙을 증명했습니다. L이 3이면 10개입니다. 펄스의 오차가 시퀀스 동안 유지되는 등의 가정 아래 성립하는 최소 보정 법칙입니다.
별도의 계산 담당 AI는 25만 건이 넘는 수치 검증을 수행했습니다. 제안을 그대로 실험으로 옮기지 않고, 더 강한 근거를 만들고 다시 확인한 것입니다.
그럴듯한 실험 계획도 다시 짰습니다
첫 실험 계획서 역시 통과하지 못했습니다. 새 법칙을 쓰지 않고 단순한 보간법으로 계산해도 비슷한 답이 나오는 설계였기 때문입니다. 연구책임자 AI는 두 방법의 차이를 제대로 가려낼 수 있도록 실험을 다시 짜게 했습니다.
결과를 본 뒤 숫자를 끼워 맞추지 못하도록 예측값과 합격 기준도 타깃 데이터를 분석하기 전에 고정하고 해시값으로 기록했습니다. 나중에 좋은 결과에 맞춰 기준을 움직일 여지를 줄인 것입니다.
정확도 기준을 통과해도 판정은 유보했습니다
첫 본 실험은 예측과 측정의 일치 여부를 평가하는 10가지 기준을 모두 통과했습니다. 그 수치만 보면 성공을 선언할 만했습니다. 그러나 장비와 측정 상태를 확인하는 대조군 검사에서 문제가 드러났습니다.
기록에는 오전 동안 7.6%의 신호 변화가 있었고, 오전 11시 48분 실험실 조명을 켠 시점과 함께 2.9%의 추가 변화가 나타났습니다. AI 연구팀은 첫 실험을 ‘판정 유보’로 남겼습니다. 데이터를 없앴다는 뜻이 아니라, 그 결과를 성공의 근거로 채택하지 않았다는 뜻입니다.
기준을 낮추는 대신 측정 방법을 바꿨습니다
AI들은 합격 기준을 완화하지 않았습니다. 조명처럼 시간에 따라 달라지는 환경이 특정 측정에만 영향을 주지 않도록, 30초 단위로 순서를 무작위화해 번갈아 측정하는 방식으로 바꿨습니다.
6시간, 21,600초에 걸친 재실험에서는 대조군 검사를 통과했습니다. 예측값 39.7과 측정값 40.0도 사전에 정한 허용오차 안에서 일치했습니다. 좋은 숫자가 나왔다는 사실에 더해, 그 숫자를 믿을 수 있는 측정 조건까지 확인한 것입니다.
비판이 실제 기각으로 이어질 때
이 타래에서 주목한 것은 AI가 그럴듯한 말을 계속 만들어내는 능력보다, 서로의 결과를 의심하고 기준에 맞지 않으면 멈추는 협업 방식입니다.
연구 주제를 기각하고, 검증력이 부족한 실험을 다시 설계하고, 정확도 기준을 통과했어도 대조군이 흔들리면 판단을 유보했습니다. 비판과 거절이 실제 연구의 다음 단계를 바꾸는 시스템이었습니다.
이 글에서 소개한 원문
Collaborative AI agents for autonomous experimental research with solid-state quantum spins
El Mustapha Mansouri, Eikichi Kimura, Masato Koga, Keigo Arai (2026)
arXiv 프리프린트 · v1
연구 원문 보기 ↗