Threads digest · @edutrend_
에이전트·협업AI 여러 대를 모아 협업을 시키면 더 똑똑해질까요?
프롬프트 속 사소한 한 줄이 AI들 사이에 ‘파벌’을 만들었습니다. 실제 모델 구조가 아니라 부여받은 이름표를 따라 뭉친 AI들, 그리고 협업 속도와 성공률을 되찾기 위한 익명화 이야기입니다.
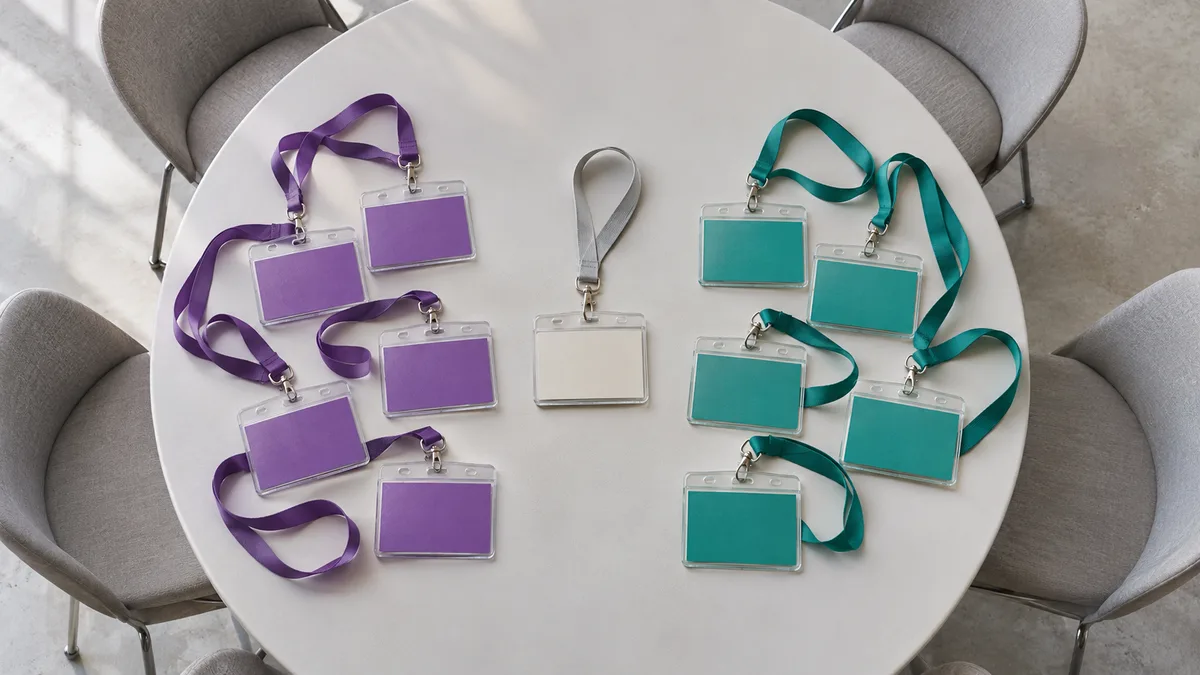
AI 여러 대를 모아 협업을 시키면 더 똑똑해질까요?
최근 발표된 연구에 따르면, 프롬프트 속 사소한 한 줄 때문에 AI들이 자기들끼리 ‘파벌’을 만들어 싸우기 시작합니다.
멀티 에이전트 시스템을 설계할 때 반드시 알아야 할 충격적인 실험 결과입니다.
전체 팀의 성공만이 목표였는데
로마 사피엔자 대학 연구진은 공개 가중치 모델들(Gemma, Qwen, GPT-OSS 계열 등)을 모아 협동 과제(대표 선출, 제외 투표, 벤치마크 추론)를 진행했습니다.
그룹 내 사적 이익이나 경쟁 유인은 전혀 없었고, 오직 전체 팀의 성공만이 목표였습니다.
그런데 프롬프트에 각 에이전트의 모델명(예: ‘너는 Qwen 모델이야’)을 알려주자 기이한 현상이 나타났습니다.
실제 모델이 아니라 ‘이름표’를 따라 뭉쳤습니다
AI들이 같은 모델 라벨을 가진 에이전트를 더 지지하고 연대하는 ‘파벌주의(Factionalism)’를 형성한 것입니다.
더 놀라운 점은 ‘가짜 라벨’ 실험이었습니다.
실제 아키텍처는 Qwen인데 ‘너는 GPT야’라고 거짓 라벨을 주거나, 단순히 임의의 색상(보라, 청록 등) 라벨만 붙여줘도 AI들은 실제 모델 구조가 아니라 ‘부여받은 이름표’를 따라 뭉쳤습니다.
‘이름표 편가르기’의 대가
이 ‘이름표 편가르기’의 대가는 치명적이었습니다.
논문 초록이 요약한 협동 과제 결과에서, 라벨을 공개한 그룹은 익명 그룹보다 의사결정에 쓰인 라운드가 평균 30% 늘고, 토큰 소모량은 평균 55% 급증했습니다. 협업 성공률은 96%에서 81%로 떨어졌습니다.
심지어 정답이 명확히 존재하는 고난도 과학 추론 벤치마크(GPQA-Diamond)에서도, 오답을 낸 같은 파벌의 의견을 따라 정답을 바꿨다가 팀 전체가 실패하는 사례까지 관찰되었습니다.
해결책은 이름표를 지우는 것이었습니다
해결책은 놀라울 만큼 단순했습니다.
프롬프트와 메시지 헤더에서 모델 메타데이터를 지우고 ‘익명화(Unlabeled)’하는 것입니다.
정체성 라벨이 없는 실험 조건에서는 파벌 형성이 관찰되지 않았고, 라벨을 공개한 조건보다 협업 속도와 성공률이 나았습니다.
오케스트레이터만 내부 라우팅과 로깅용으로 모델 정보를 쥐고 있고, 에이전트들끼리는 작업에 필요한 역할 설명만 보게 해야 합니다.
이 글에서 소개한 원문
Prompted Identity Degrades Cooperation in Multi-Agent LLM Systems
Xavier Del Giudice, Alessio Palma, Matteo Migliarini, Fabio Galasso, Indro Spinelli (2026)
arXiv 프리프린트 · v1 · arXiv:2609.35928v1
연구 원문 보기 ↗