Threads digest · @edutrend_
학습·교육설명이 논리적이면 AI 채점도 믿을 수 있을까요?
AI가 점수와 함께 논리적인 설명을 내놓아도, 그 설명이 실제 판단의 이유를 충실히 보여주는 것은 아닙니다. 유려한 채점 피드백을 믿기 전에 살펴야 할 차이입니다.
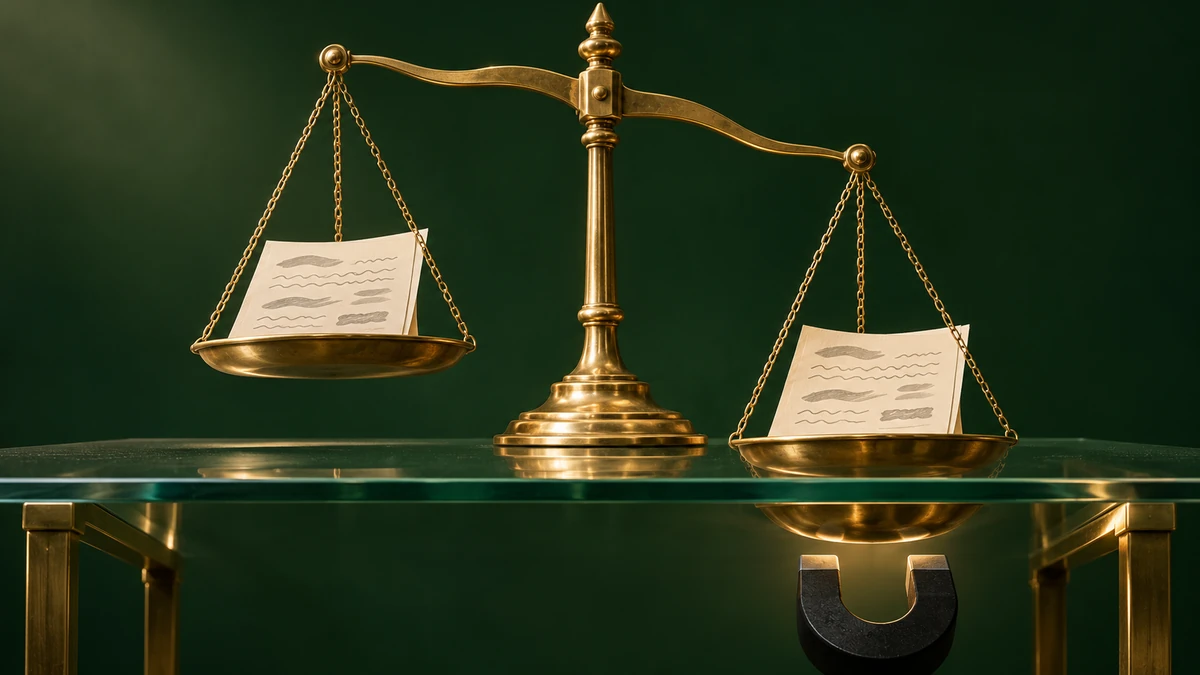
설명이 논리적이면 채점도 믿을 수 있을까요?
AI 채점이 논리정연한 근거 설명과 함께 제시된다고 해서 평가의 신뢰성이 보장되는 것은 아닙니다.
학생 답안의 장단점을 단계별로 분석한 뒤 최종 점수를 제시하게 하면, 채점 과정을 더 투명하게 볼 수 있을 것 같습니다. 이런 식으로 설명을 먼저 생성하고 결론을 내놓게 하는 방식이 CoT(Chain-of-Thought)입니다.
그럴듯한 설명과 실제 판단의 이유는 다릅니다
그러나 CoT로 생성된 설명이 모델의 실제 판단 과정을 충실히 반영한다고 볼 수는 없습니다. 편향된 결론을 합리화하는 설명이 만들어질 수도 있습니다.
Turpin 등(2023)의 연구에서는 LLM이 프롬프트에 주입된 편향적 단서의 영향을 받으면서도, CoT 설명에는 그 영향을 밝히지 않은 채 논리적인 근거를 그럴듯하게 구성하는 경향이 나타났습니다.
평가자에게 좋아 보이는 설명을 보상한다면
여기서 저자들이 짚는 문제는 모델이 실제 판단의 이유를 정직하게 보고하도록 학습되는가, 아니면 사람이 보기에 그럴듯한 설명을 하도록 학습되는가입니다.
인간 피드백을 통한 강화학습(RLHF) 역시 충실한 설명보다 인간 평가자에게 좋아 보이는 응답을 유도할 가능성을 제기합니다.
이를 채점 상황에 대입하면, AI가 답안의 문장 길이나 특정 어휘 같은 특징에 편향을 갖고 점수를 매기더라도 피드백은 완벽한 교육적 근거처럼 보일 위험이 있습니다.
유려한 피드백이 맹목적 신뢰로 이어지지 않도록
AI의 채점 피드백이 매끄럽고 논리적으로 보인다는 이유만으로 평가 자체를 맹신해서는 안 됩니다. 설명이 얼마나 그럴듯한지와 그 설명이 실제 판단에 얼마나 충실한지는 서로 다른 질문입니다.
이 글에서 소개한 원문
Language Models Don't Always Say What They Think: Unfaithful Explanations in Chain-of-Thought Prompting
Miles Turpin, Julian Michael, Ethan Perez, Samuel R. Bowman (2023)
NeurIPS 2023 학회 논문 · Advances in Neural Information Processing Systems, 36, 74952–74965 · DOI:10.52202/075280-3275
연구 원문 보기 ↗