Threads digest · @edutrend_
학습·교육서논술형 평가, AI 채점 지원은 과연 유효할까요?
예시 답안을 주자 AI의 평균 점수는 사람과 가까워졌지만, 개별 글의 질을 구별하는 능력은 따라오지 않았습니다. 서논술형 평가에서 교사의 판단과 AI의 보조 역할을 나누어 봅니다.
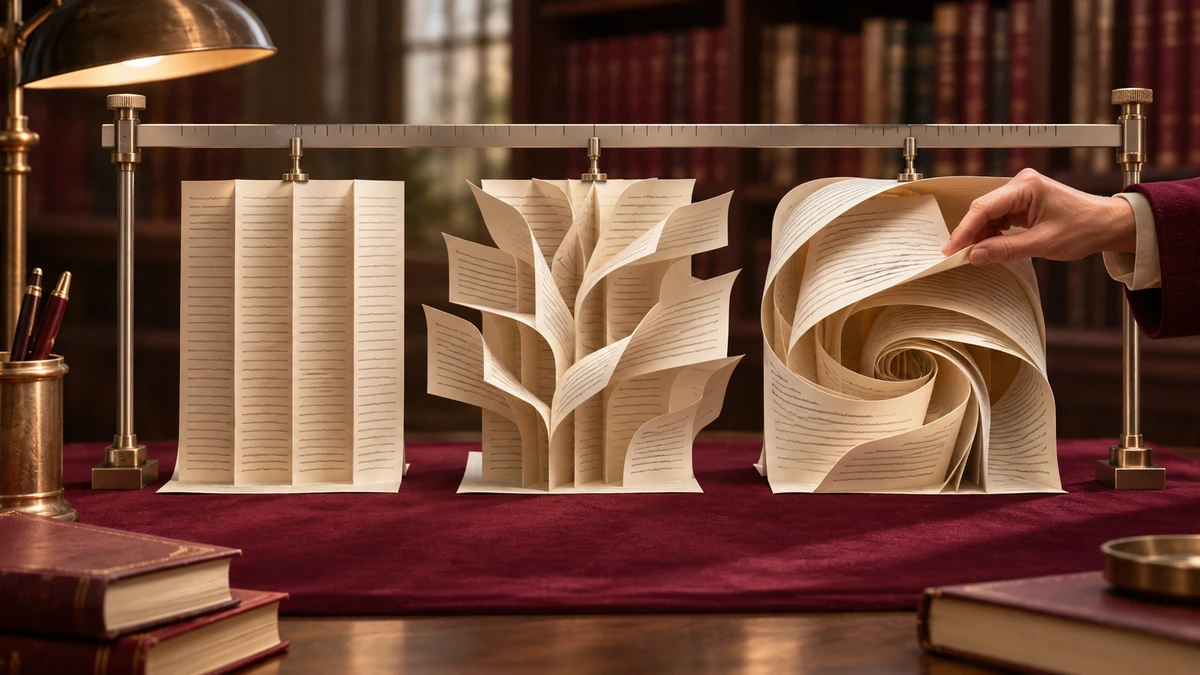
서논술형 평가의 채점을 AI에게 맡겨도 될까요?
서논술형 평가에서 AI의 채점 지원은 과연 유효할까요? Yeadon 등(2026)은 서논술형 평가가 다른 문항 유형과 근본적으로 다르다는 점에 주목합니다.
핵심은 ‘기준 참조 가능성’입니다. 채점 기준을 잣대처럼 답안에 명확하게 대어 볼 수 있는가에 따라 AI 평가의 타당성도 달라질 수 있다는 것입니다.
에세이는 하나의 잣대만으로 평가하기 어렵습니다
서논술형 에세이를 채점하려면 논리의 흐름, 표현력, 글 전체의 맥락을 함께 보아야 합니다. 무엇에 얼마만큼의 무게를 둘지에 채점자의 판단이 개입하므로, 기준을 명확한 특징에 대응시키기가 어렵습니다.
이런 과제에서는 기준 참조 가능성이 낮습니다. AI에게 점수표를 주는 것만으로 평가의 문제가 모두 해결되기 어려운 이유입니다.
평균이 비슷해져도, 글을 구별하는 능력은 별개입니다
AI에게 채점 지침과 점수가 붙은 여러 수준의 예시 답안을 제공하면 어떤 일이 일어날까요? AI 점수의 평균은 사람의 평균에 가까워지고, 점수 분포는 사람보다 더 좁아졌습니다.
하지만 개별 글의 질을 구별해 점수의 순서를 매기는 능력은 여전히 낮았습니다. 어떤 글이 90점짜리이고 어떤 글이 60점짜리인지 구별하는 문제를 떠올리면 이해하기 쉽습니다. 여기서 90점과 60점은 차이를 설명하기 위한 예시입니다.
이 결과는 AI가 에세이의 내용과 논리를 더 타당하게 평가하게 되었다는 증거가 되지 못합니다. 예시가 보여준 점수대에 맞춰 평균적으로 그럴듯한 점수를 내는 것만으로도, 사람 점수와의 겉보기 차이는 줄어들 수 있기 때문입니다.
교사의 평가적 판단은 어디에 남아 있어야 할까요?
AI를 서논술형 평가의 채점에 적용할 때에도 AI에 대한 비판적 이해가 필요합니다. 특히 서논술형 평가에서 AI가 점수를 매기는 채점자의 역할로서 작동하는 것은 바람직하지 않습니다.
인간의 평가적 판단력이 필요한 영역과 위임할 수 있는 영역을 명확히 구분해야 합니다. 교사의 인지적 에너지가 학생의 이해를 추적하는 데 온전히 사용될 수 있도록, AI는 절대적으로 보조적인 역할을 수행해야 합니다.
이 글에서 소개한 원문
Criterion-referenceability determines LLM-as-a-judge validity across physics assessment formats
Will Yeadon, Tom Hardy, Paul Mackay, Elise Agra (2026)
arXiv 사전공개 논문 · 작성자 인용 제목에 해당하는 v1 · arXiv:2603.14732v1
연구 원문 보기 ↗